


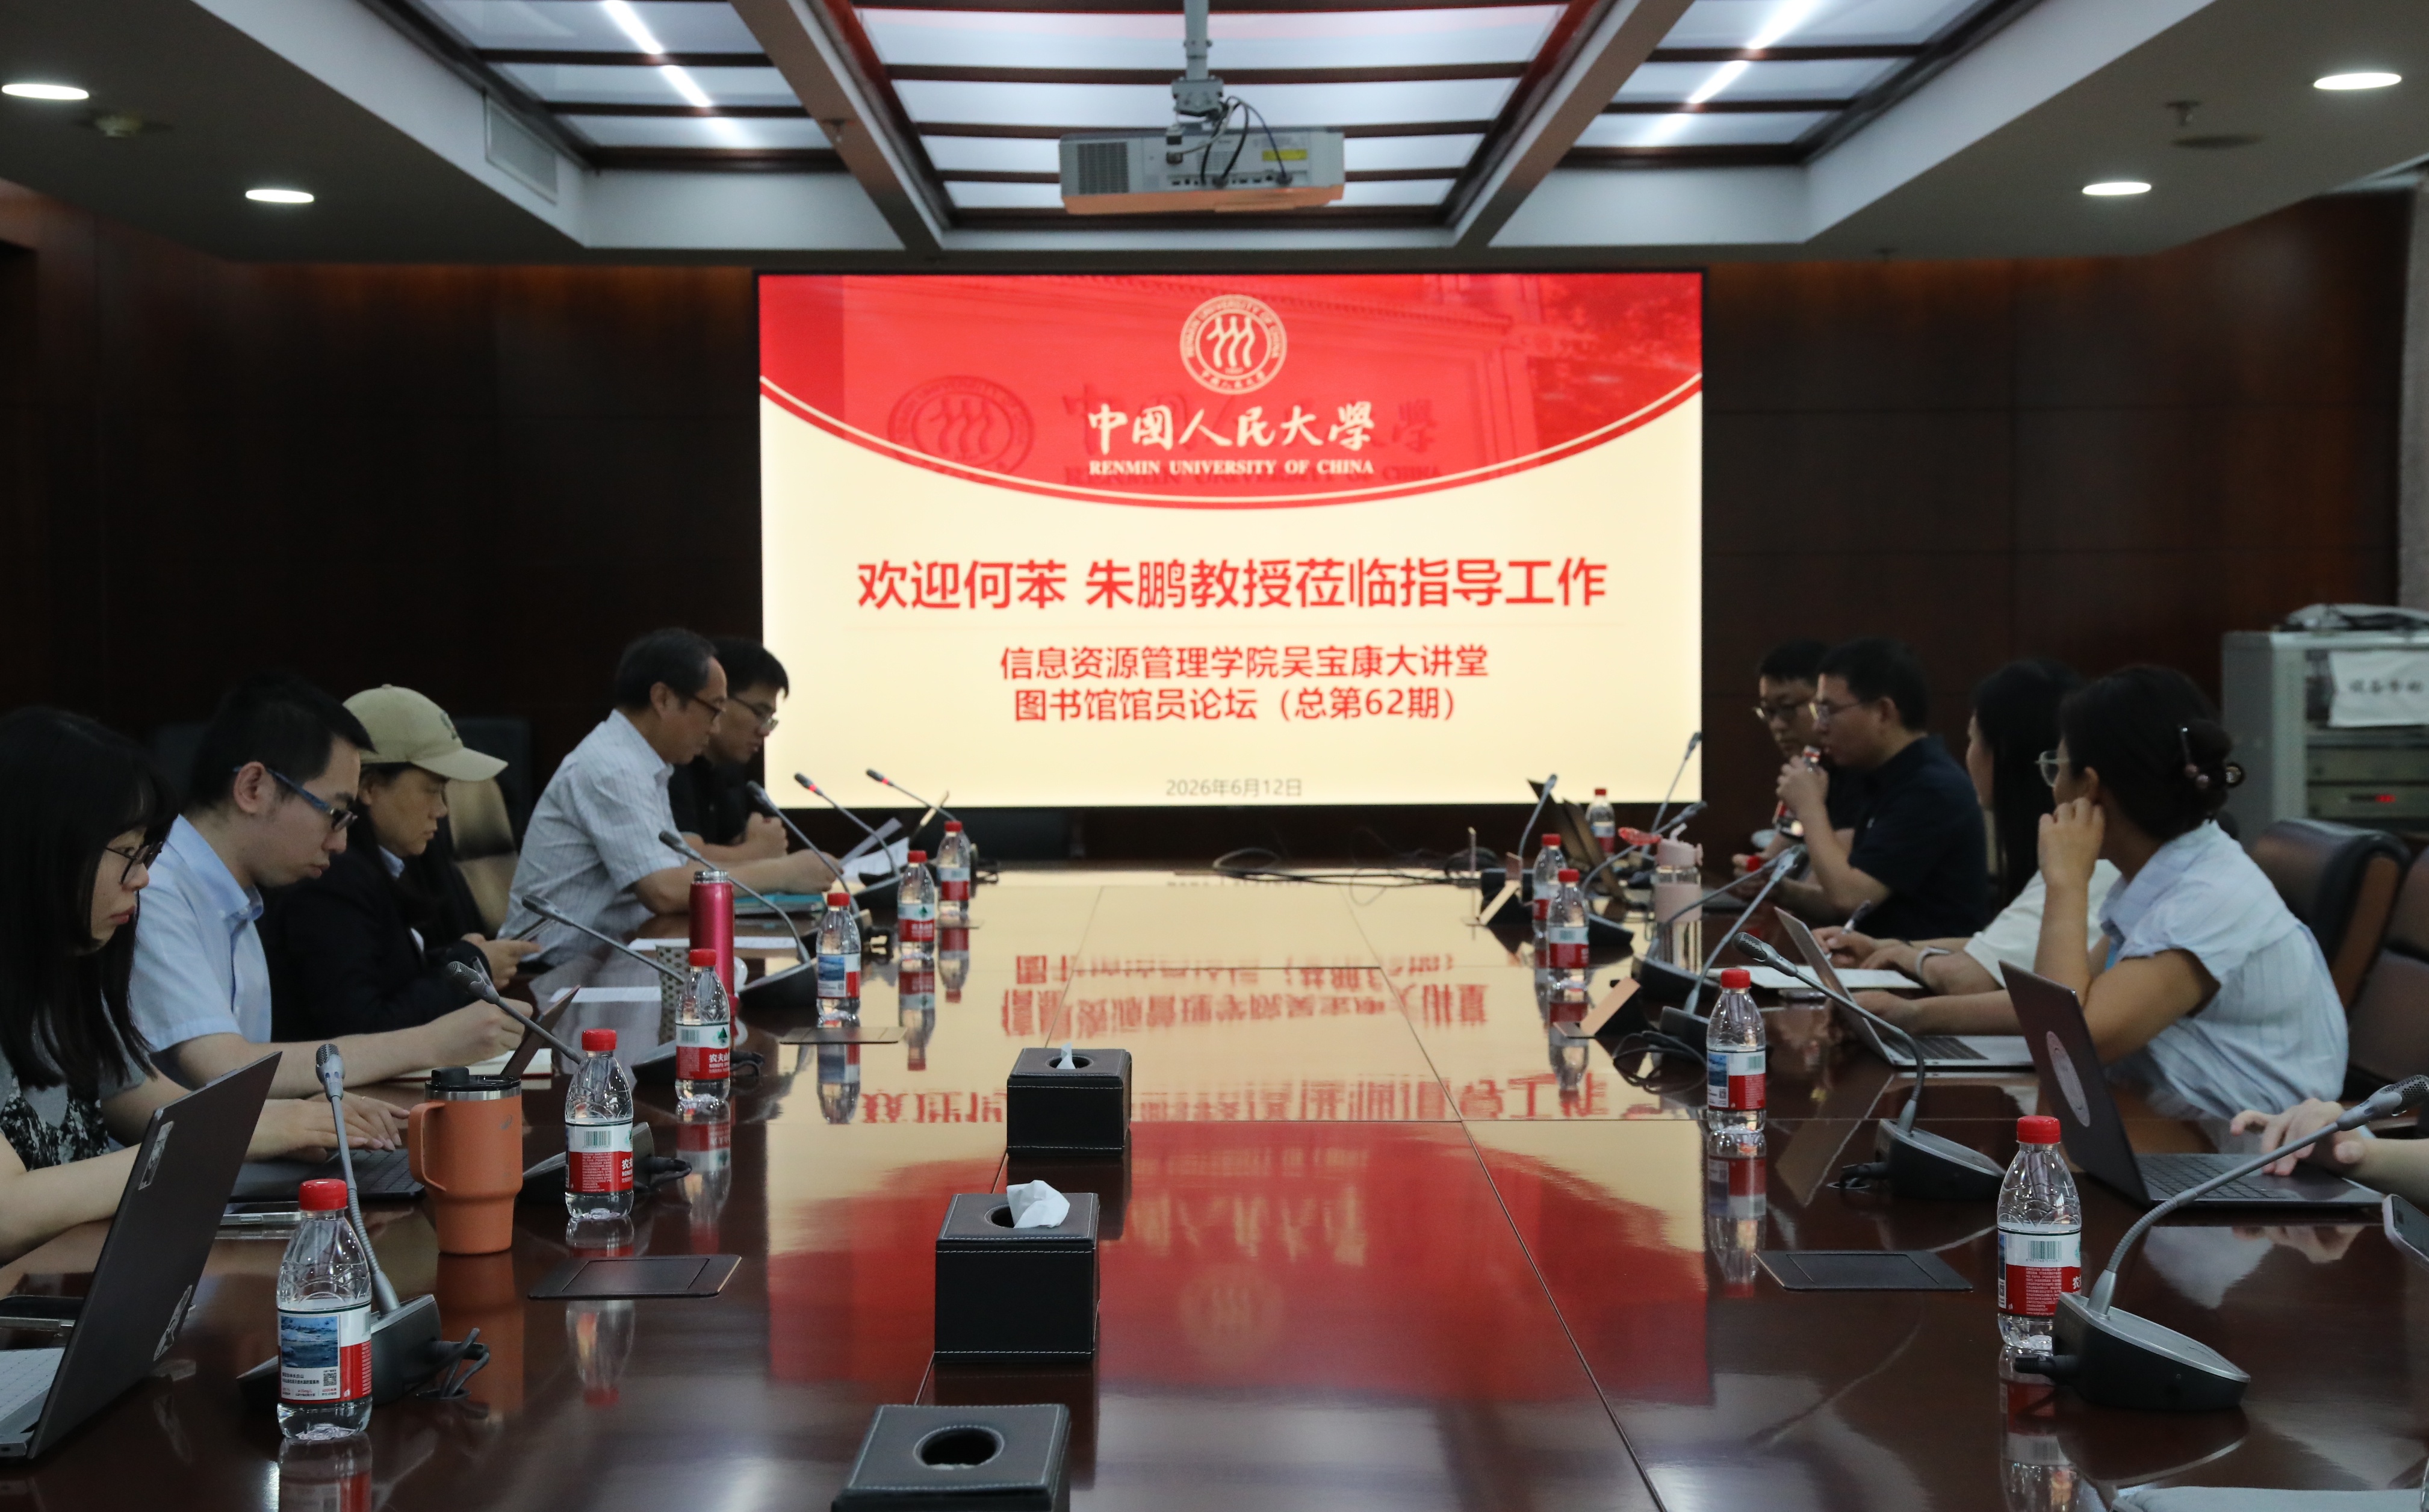
2026年6月12日下午,女生自慰 举办“吴宝康大讲堂”第四十讲,邀请中国科学院大学计算机科学与技术学院何苯教授、南京理工大学经济管理学院朱鹏教授分别作题为“大模型生成内容对检索系统的影响探讨”与“不确定环境下的可信情报评估”的专题讲座。此次讲座由女生自慰 张斌教授与卢小宾教授主持,贾君枝教授、钱明辉教授、杨冠灿副教授、霍朝光副教授、方志超老师、严承希老师、周虹宇老师等多名师生参与。
何苯教授围绕大语言模型生成内容对信息检索系统的长期影响,重点讨论了在建设增强生成系统(RAG)广泛应用的背景下,大语言模型(LLM)生成文本可能因更易被检索系统偏好而不断占据检索结果前列,进而削弱人类原创内容可见性、降低信息多样性并放大错误信息的“沉默螺旋”现象。何苯教授通过构建迭代模拟实验框架,展示了LLM生成文本持续进入检索索引后对系统性能、内容来源分布与结果多样性的影响。在此基础上,进一步介绍了效用驱动的多目标优化框架,通过平衡检索效果、生成文本占比、结果多样性与事实正确性等多重算法优化目标,以缓解大模型时代的信息生态失衡问题。
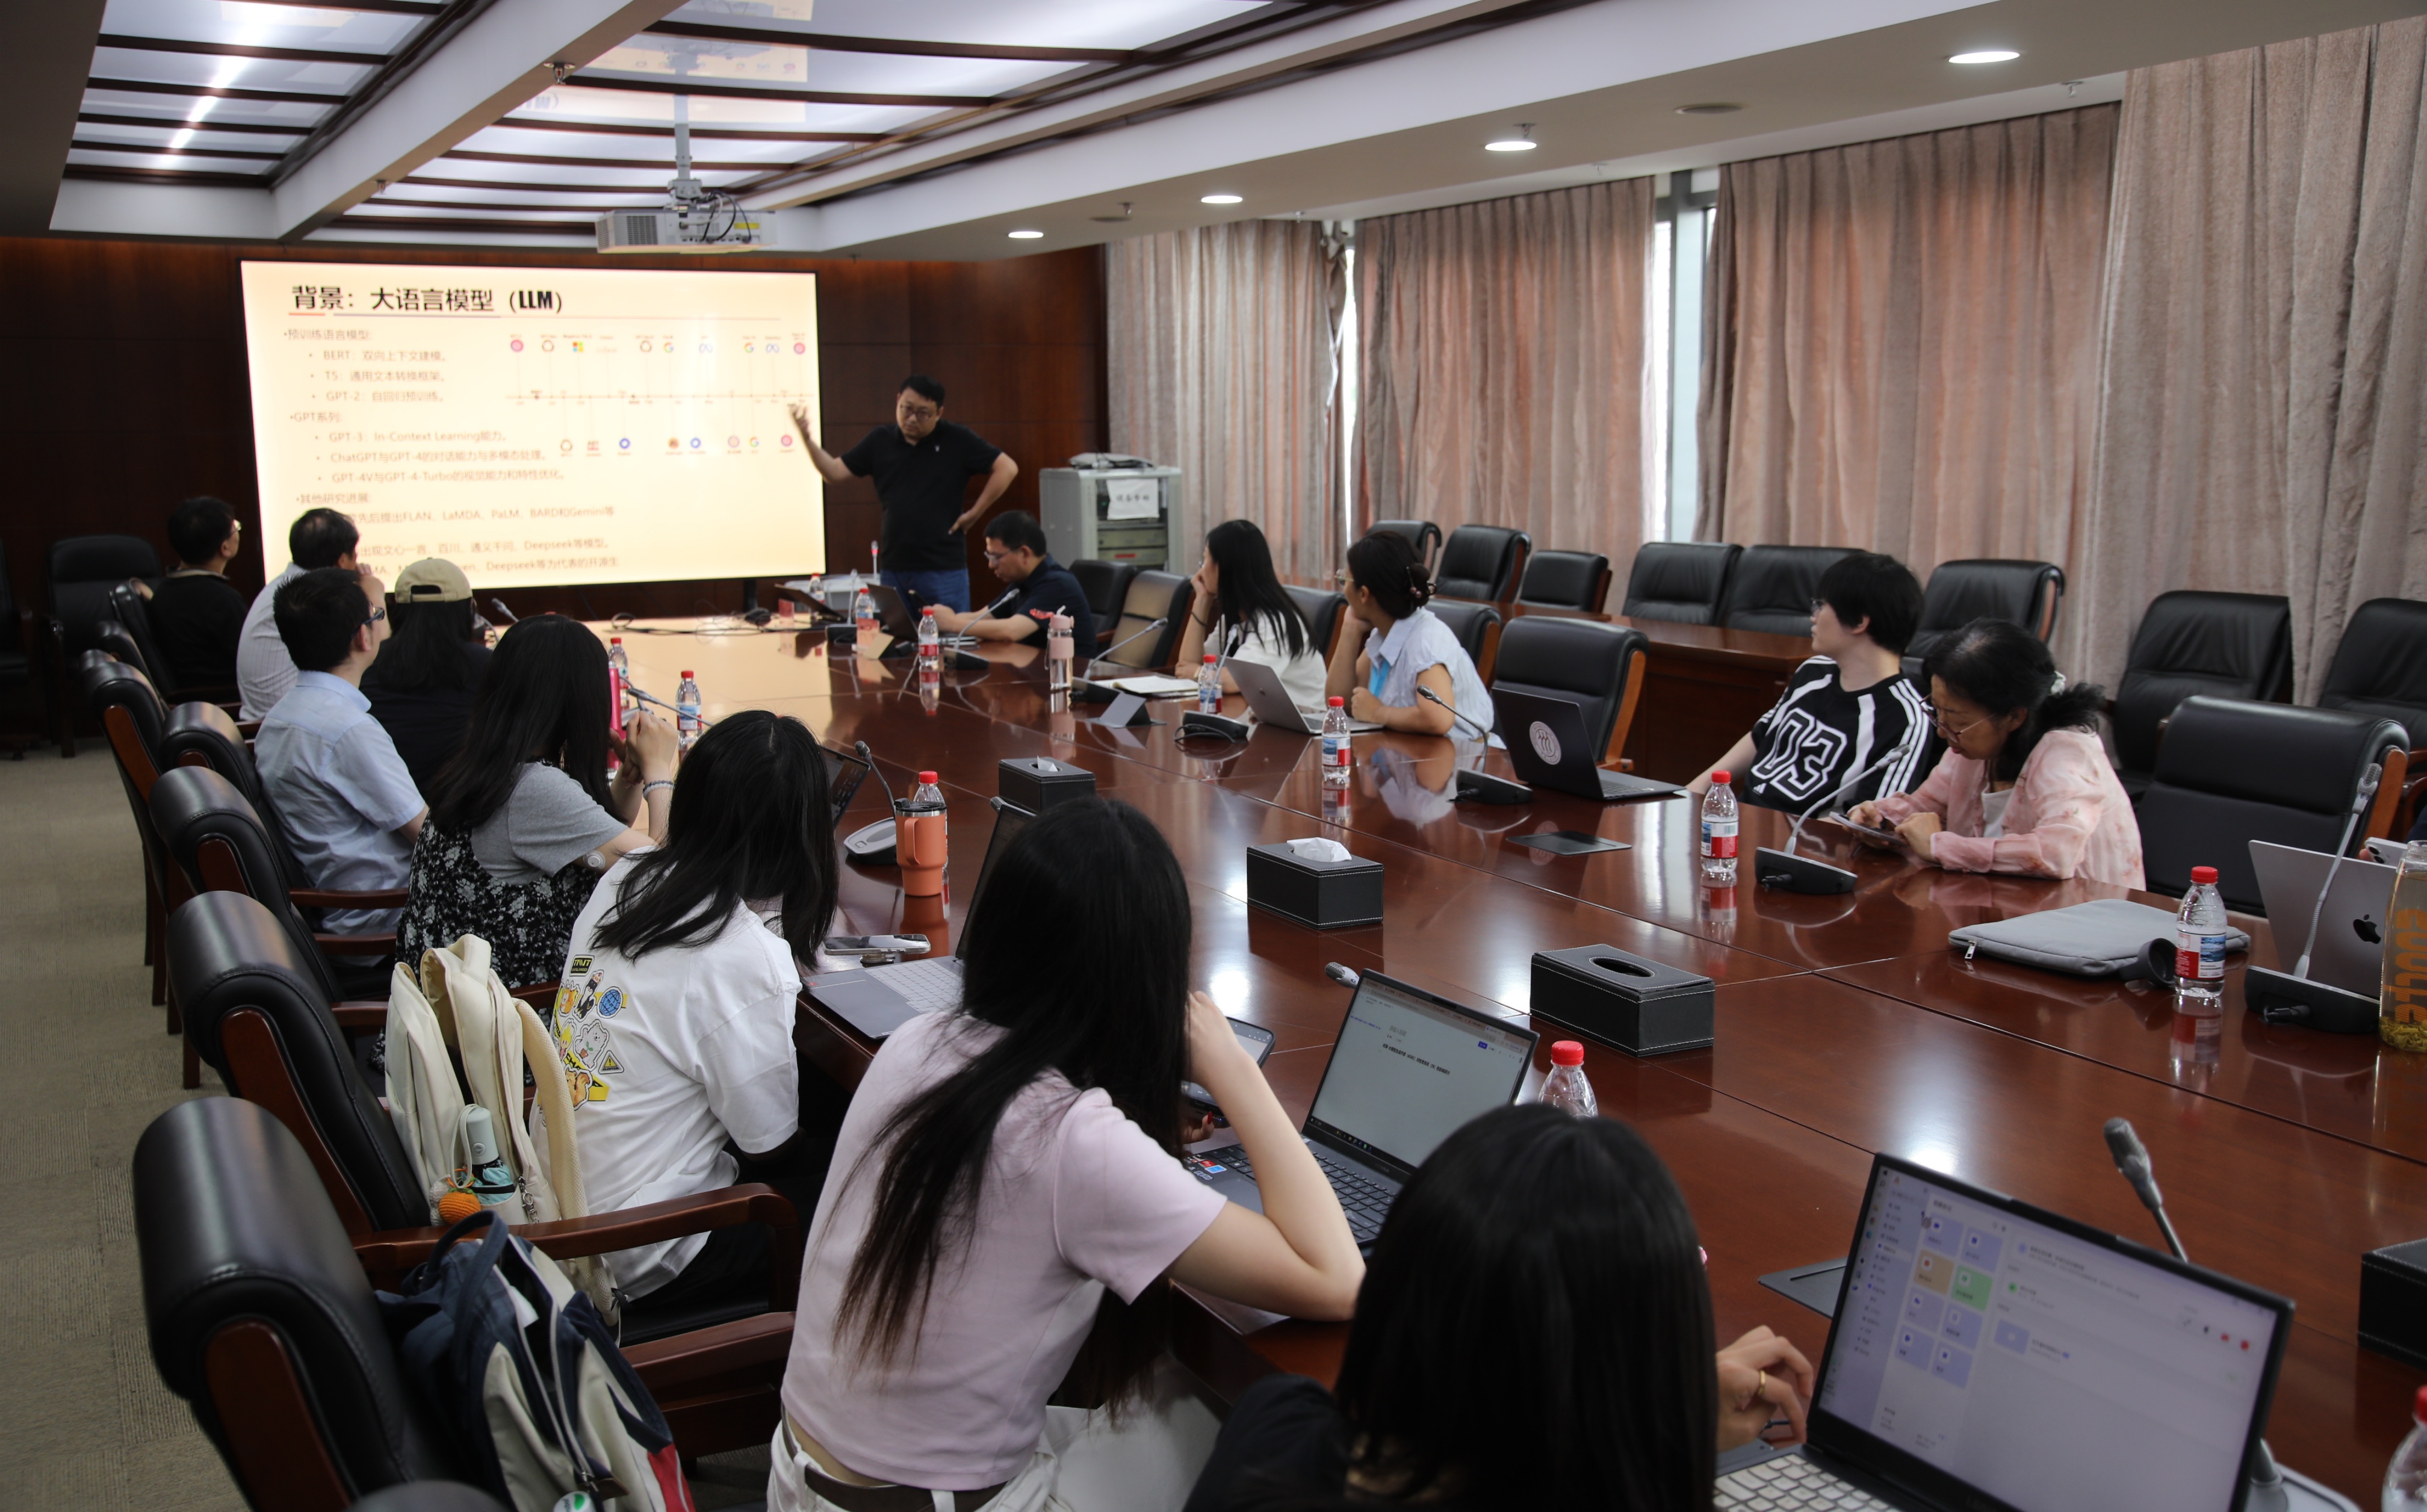
朱鹏教授立足国防情报评估对情报可信度的核心要求,系统探讨了国防情报的智能样本管理方法及可信建模与解释。针对错误标注、主观偏差、模糊样本、过时信息、敌方干扰等情况带来的数据标签偏误问题,采用元学习方法对标签噪声进行识别,以确保样本分类与真实情况的一致性。针对传统样本选择方法难以适应国防情报复杂动态要求的问题,通过整数规划对样本进行筛选,以确保数据样本与任务需求的高度相关性。针对AI模型的可解释性问题,采用可解释人工智能(XAI)方法对模型性能进行多准则评估,并引入标签噪声过滤器以提高模型评估解释质量,有效提升了模型的可信性、可读性与透明性。
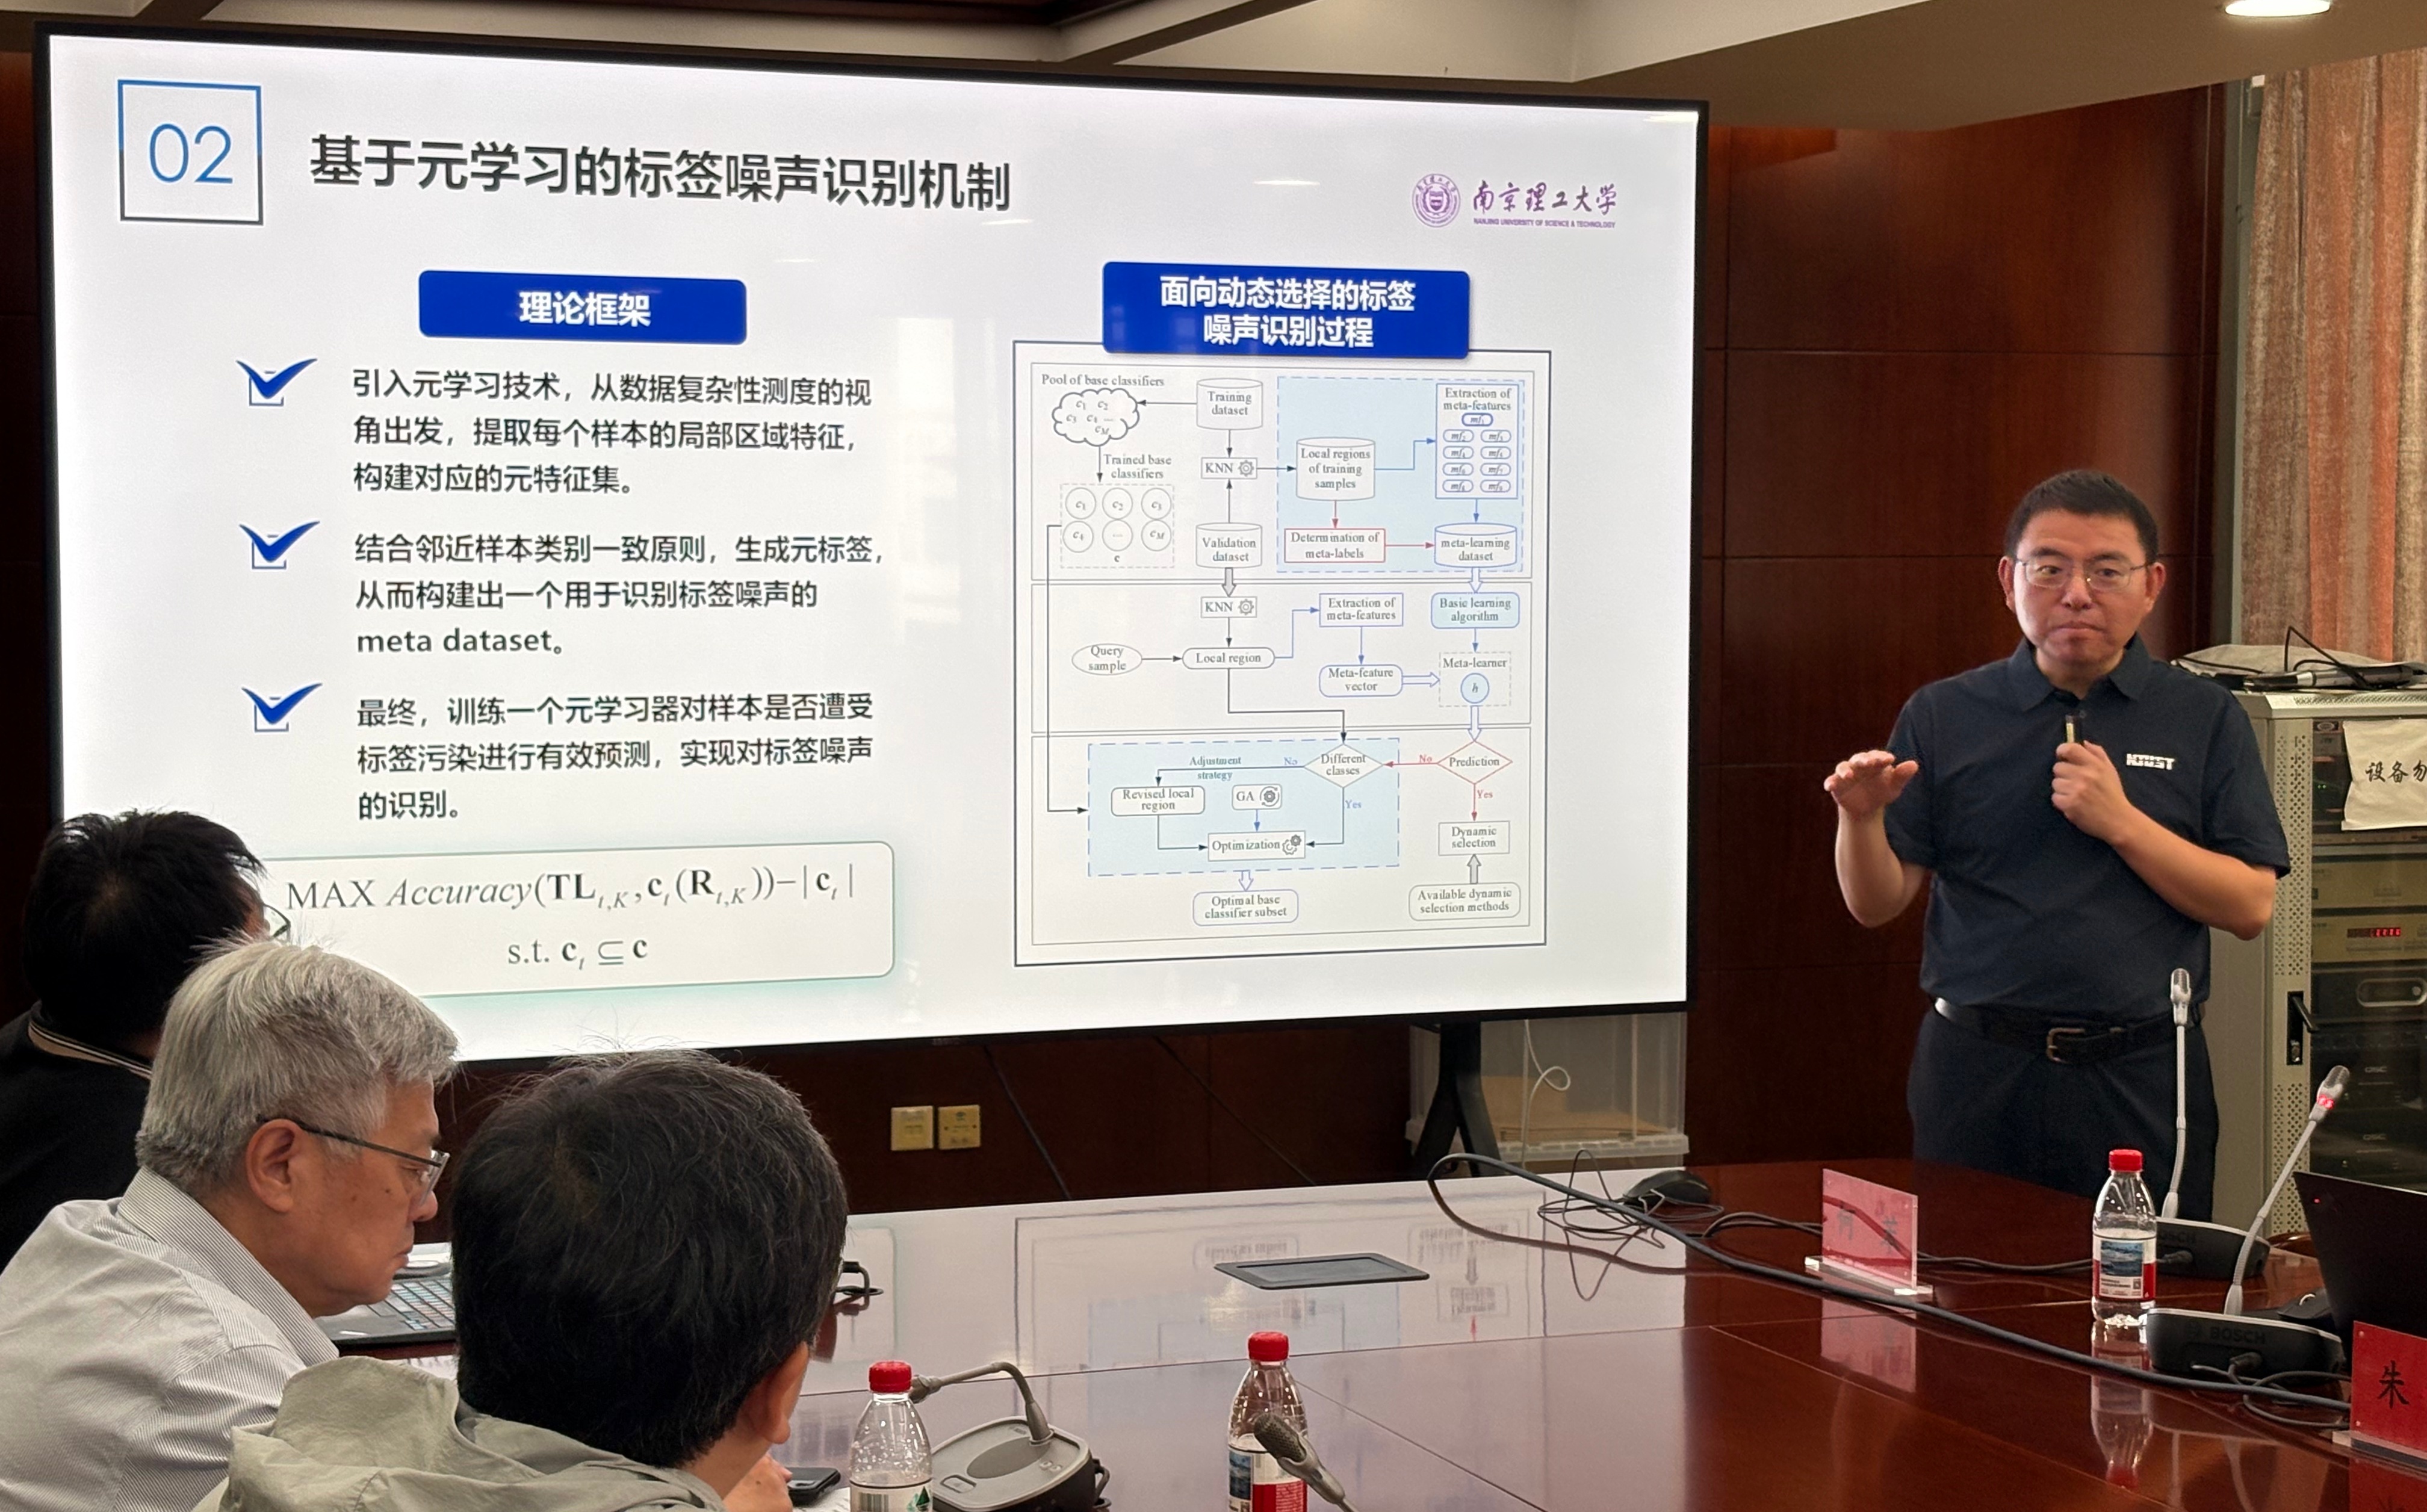
交流环节中,参会师生与何苯教授及朱鹏教授就大模型对非人类生成内容偏好的机制验证、大模型生成内容同质化对AI内容识别带来的挑战、军事领域大模型相关资讯的获取途径等问题展开了讨论。此次讲座为学院师生理解大模型与信息检索系统的互动机制、了解国防情报领域的战略价值与发展现状提供了重要启发,为智能信息检索系统、大模型技术影响评价、情报质量评估管理等研究领域提供了重要借鉴。
摄影:刘昭辉
撰稿:但婷婷、张文嘉
审核:霍朝光
核发:韩曙光、闫慧